
Dal chroot a Docker: breve storia dell'arte di mentire ai processi
Container, namespace, cgroup, OverlayFS: 34 anni di bugie ben coordinate raccontate dal kernel ai processi, dal chroot del 1979 alla balena di Docker.
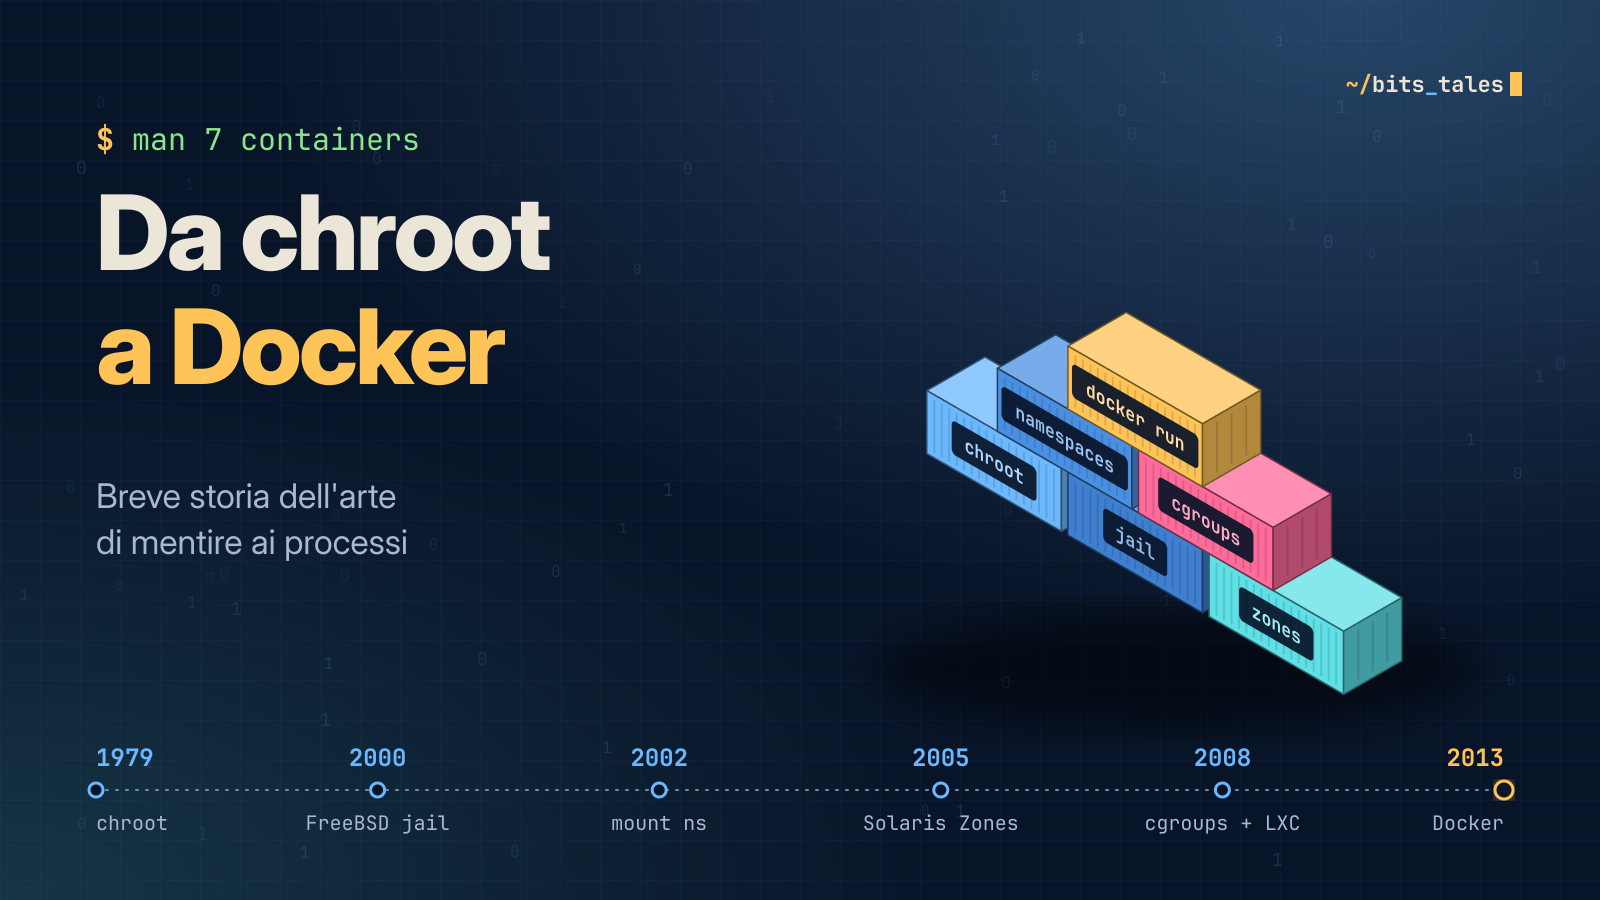
Ogni sviluppatore, prima o poi, ha pronunciato la frase più pericolosa dell'informatica: «Ma sulla mia macchina funziona». Per decenni la risposta del team operations è stata un sospiro. Poi, nel 2013, qualcuno ha risposto: «Perfetto, allora spediamo la tua macchina». E così è nato Docker.
Solo che non è andata proprio così. Docker è l'ultimo capitolo di una storia lunga più di trent'anni, fatta di syscall dimenticate, patch del kernel mai accettate, ingegneri di Google che litigano sui nomi e un hacker chiuso in una prigione finta in New Jersey. Mettetevi comodi: si parte dal 1979.
Spoiler: i container non esistono
Cominciamo con una rivelazione che rovina la sorpresa: nel kernel Linux non esiste nessun oggetto chiamato "container". Non c'è una struct container, non c'è una syscall create_container(). Un container è un normalissimo processo a cui il kernel racconta bugie molto ben coordinate:
- namespace: decidono cosa vede il processo (quali PID, quale hostname, quali interfacce di rete, quali mount);
- cgroup: decidono quanto può consumare (CPU, memoria, I/O, numero di processi);
- un filesystem a strati: decide dove vive;
- capabilities, seccomp, LSM: decidono cosa può fare, anche quando crede di essere root.
Un container, insomma, è un processo con una realtà virtuale su misura. Vediamo come ci siamo arrivati, un inganno alla volta.
1979: chroot, ovvero "la tua root è dove dico io"
Tutto comincia in Version 7 Unix, nel 1979, con una syscall dall'aria innocua: chroot(2). Fa una cosa sola: cambia la directory che un processo considera /. Dopo chroot("/srv/gabbia"), quando il processo apre /etc/passwd il kernel risolve in realtà /srv/gabbia/etc/passwd. In Linux è letteralmente un puntatore (current->fs->root) che viene spostato.
Non era nata per la sicurezza: serviva a costruire e testare il sistema in un albero separato. Nel 1982 Bill Joy la porta in BSD, e da lì diventa il trucco preferito di chiunque voglia isolare un demone (FTP anonimo, BIND, ecc.).
Nel gennaio 1991 Bill Cheswick, ai Bell Labs, intrappola un cracker in un ambiente chroot costruito a mano e lo osserva per mesi, raccontandolo poi nel paper "An Evening with Berferd". Da qui nasce l'espressione chroot jail. Romantico, ma c'è un problema: chroot non è una prigione. È più una porta a cui hai dipinto sopra un muro.
Il classico modo per evadere, se sei root dentro il chroot:
#include <unistd.h>
#include <sys/stat.h>

int main(void) {
    mkdir("tunnel", 0755);
    chroot("tunnel");          /* nuova root... ma la cwd resta FUORI */
    for (int i = 0; i < 1024; i++)
        chdir("..");           /* nessuno ci ferma: non siamo "sotto" la root */
    chroot(".");               /* benvenuti nella vera / dell'host */
    return execl("/bin/sh", "sh", (char *)NULL);
}
Il trucco: chroot() non sposta la directory corrente. Se la cwd è fuori dalla nuova root, il controllo su .. non scatta mai e si risale fino alla vera radice. La man page di Linux, con onestà disarmante, lo dice chiaramente: chroot non è pensata come meccanismo di sicurezza. Ricordatevelo, perché ci torneremo quando parleremo di pivot_root.
2000: FreeBSD Jail, la prima vera prigione
Nel 2000 Poul-Henning Kamp, su commissione di un provider di hosting che voleva dare ai clienti un "root" senza dar loro le chiavi di casa, introduce in FreeBSD 4.0 la syscall jail(2). Il paper che la descrive ha un titolo bellissimo: "Jails: Confining the omnipotent root".
Una jail non cambia solo la root del filesystem: ha il suo hostname, il suo indirizzo IP, e soprattutto il kernel sa che quel processo è in una jail. Root dentro la jail non può caricare moduli, creare device node, toccare la rete dell'host o vedere processi esterni. Per la prima volta l'isolamento è una proprietà del kernel, non una convenzione.
Linux nel frattempo guarda e prende appunti. In pratica, li prende sotto forma di patch esterne al kernel: Linux-VServer (2001) e Virtuozzo/OpenVZ (2000/2005) offrono container veri, ma richiedono un kernel patchato, enorme e mai accettato nel mainline. Se avete avuto una VPS economica a metà anni 2000, con buona probabilità era un container OpenVZ che fingeva di essere una macchina virtuale. Sorpresa!
2004-2005: Solaris Zones, quando Sun inventa la parola
Sun Microsystems, con Solaris 10 (2005), presenta le Zones: istanze isolate del sistema operativo che condividono un solo kernel, combinate con controlli di risorse. Al marketing di Sun il nome tecnico non bastava e il tutto venne venduto come Solaris Containers. La parola "container" entra così nel vocabolario mainstream. Le "branded zones" riuscivano addirittura a far girare binari Linux sopra il kernel Solaris, traducendo le syscall. Gli sviluppatori Linux, nel frattempo, stavano ancora discutendo su come chiamare le cose.
2002-2020: i namespace, ovvero mentire a rate
Linux sceglie una strada diversa da jail e zones: invece di un unico oggetto "prigione", tante piccole primitive indipendenti, ognuna delle quali virtualizza una risorsa globale. L'ispirazione arriva da Plan 9, il sistema operativo dei Bell Labs in cui ogni processo aveva il suo namespace.
Il primo arriva nel 2002, con il kernel 2.4.19: il mount namespace, opera di Al Viro. Il flag si chiama CLONE_NEWNS, cioè "NEW NameSpace", genericissimo, perché nessuno immaginava che ne sarebbero arrivati altri. Ne sono arrivati altri sette:
| Namespace | Flag | Kernel (anno) | Cosa isola |
|---|---|---|---|
| Mount | CLONE_NEWNS | 2.4.19 (2002) | punti di mount |
| UTS | CLONE_NEWUTS | 2.6.19 (2006) | hostname e domainname |
| IPC | CLONE_NEWIPC | 2.6.19 (2006) | IPC System V, code di messaggi POSIX |
| PID | CLONE_NEWPID | 2.6.24 (2008) | numerazione dei processi |
| Network | CLONE_NEWNET | 2.6.24–2.6.29 (2008-09) | interfacce, routing, firewall, socket |
| User | CLONE_NEWUSER | 3.8 (2013) | UID/GID e capabilities |
| Cgroup | CLONE_NEWCGROUP | 4.6 (2016) | vista della gerarchia cgroup |
| Time | CLONE_NEWTIME | 5.6 (2020) | offset di CLOCK_MONOTONIC e BOOTTIME |
(Curiosità: "UTS" sta per UNIX Time-sharing System, dalla struct utsname. Un namespace intero con un nome degli anni '70 serve, in pratica, a far credere a un processo di chiamarsi in un altro modo.)
Le syscall sono tre: clone() crea un processo in nuovi namespace, unshare() sposta il processo corrente in namespace nuovi, setns() entra in un namespace esistente (è quello che fa docker exec). Si provano senza scrivere una riga di C:
$ sudo unshare --uts --pid --fork --mount-proc bash
# hostname container-artigianale
# hostname
container-artigianale
# ps aux
USER  PID %CPU %MEM COMMAND
root    1  0.0  0.0 bash
root    8  0.0  0.0 ps aux
Il nostro bash crede di essere PID 1, cioè init. Congratulazioni per la promozione! Però essere PID 1 comporta due responsabilità che quasi tutti scoprono a proprie spese:
- Diventi il genitore adottivo di tutti gli orfani: se non fai
wait()sui figli rimasti orfani, il namespace si riempie di zombie. - Il kernel ignora i segnali per cui non hai installato un handler: per proteggere init, SIGTERM e SIGINT senza handler non hanno effetto. Ecco perché a volte
docker stopaspetta 10 secondi e poi ricorre a SIGKILL.
È esattamente il motivo per cui esistono init minimi come tini. (Se fate docker ps sul server di questo blog, il container della posta parte proprio con /tini.)
2006-2008: i cgroup, ovvero "dieta obbligatoria"
I namespace decidono cosa vedi, ma non impediscono a un processo di mangiarsi tutta la RAM. Nel 2006 due ingegneri di Google, Paul Menage e Rohit Seth, propongono i "process containers": un meccanismo per raggruppare processi e assegnare limiti di risorse al gruppo. Nel kernel però la parola "container" significava già troppe cose, quindi vengono ribattezzati control groups. Entrano nel mainline con il 2.6.24 (gennaio 2008). Google li usava già in produzione su Borg, il suo orchestratore interno, dove praticamente tutto girava in container molto prima che fosse di moda.
La prima versione (v1) prevedeva una gerarchia diversa per ogni controller (cpu, memory, blkio...): flessibile in teoria, un incubo in pratica. Con il kernel 4.5 (2016) Tejun Heo stabilizza i cgroup v2, con una gerarchia unica. L'interfaccia è deliziosamente Unix: tutto è un file.
# cat /sys/fs/cgroup/cgroup.subtree_control   # controller abilitati (di solito ci pensa systemd)
cpuset cpu io memory pids
# mkdir /sys/fs/cgroup/dieta
# echo 100M          > /sys/fs/cgroup/dieta/memory.max
# echo "50000 100000" > /sys/fs/cgroup/dieta/cpu.max   # 50 ms ogni 100 ms = mezza CPU
# echo 64            > /sys/fs/cgroup/dieta/pids.max  # addio fork bomb
# echo $$            > /sys/fs/cgroup/dieta/cgroup.procs
Da questo momento la shell e tutti i suoi figli vivono a dieta. Se superano i 100 MB, il kernel non chiede per favore: interviene l'OOM killer all'interno del gruppo, e il resto del sistema non se ne accorge. È esattamente quello che succede quando passate --memory=100m a docker run.
2008: LXC, tutti gli ingredienti in pentola
Nel 2008, per la prima volta, il kernel Linux vanilla ha tutto il necessario: namespace più cgroup, senza patch esterne. Nasce LXC (LinuX Containers), un insieme di strumenti in userspace che compone i pezzi. Funzionava, ed era potente. Era anche usabile quanto montare un armadio con le istruzioni in sanscrito: file di configurazione lunghi, template di distribuzione, rete da configurare a mano. Mancavano poi gli user namespace completi (arrivati solo nel 2013), quindi root nel container era, a tutti gli effetti, root sull'host.
Altri ci provano: Cloud Foundry con Warden (2011) e Google, nel 2013, pubblica lmctfy, "Let Me Contain That For You". Nomi a parte, la tecnologia c'era tutta. Mancava qualcosa di più difficile: un'esperienza utente.
2013: Docker, ovvero il marketing della scatola
dotCloud era una piccola azienda di Platform-as-a-Service che, come Heroku, usava i container internamente. Nel marzo 2013, alla PyCon di Santa Clara, il fondatore Solomon Hykes tiene un lightning talk di cinque minuti intitolato "The future of Linux Containers" e mostra uno strumento interno appena rilasciato open source: Docker. Pochi mesi dopo, dotCloud cambia nome in Docker, Inc. Il resto è storia (e migliaia di Dockerfile con FROM ubuntu:latest).
Ironia della sorte: Docker non ha inventato nessuna tecnologia di isolamento. Le prime versioni, scritte in Go, erano un wrapper attorno a LXC. Con la 0.9 (marzo 2014) il backend predefinito diventa libcontainer, una libreria Go che parla direttamente con namespace e cgroup. La vera innovazione era altrove:
- L'immagine come artefatto: un pacchetto immutabile, versionato, con tutto il filesystem dell'applicazione.
- Il Dockerfile: una ricetta riproducibile (più o meno:
apt-get updatela pensa diversamente). - Il registry:
docker pushedocker pull, come git ma per interi sistemi. - La UX:
docker run -it ubuntu bash. Un comando. Fine.
Il trucco degli strati
Il cuore delle immagini è il filesystem a strati (union filesystem): prima AUFS, oggi quasi sempre OverlayFS (driver overlay2). Ogni istruzione del Dockerfile produce uno strato in sola lettura, identificato dall'hash SHA-256 del suo contenuto. Al momento del run si aggiunge sopra uno strato scrivibile:
# mount -t overlay overlay \
    -o lowerdir=/strati/app:/strati/python:/strati/debian,upperdir=/rw,workdir=/work \
/merged- Le letture attraversano gli strati dall'alto verso il basso: vince il primo che ha il file.
- La prima scrittura su un file di uno strato inferiore provoca un copy-up: il file intero viene copiato in
upperdir(sì, anche se modificate un byte di un file da 2 GB). - Cancellare un file crea un whiteout: un device a caratteri 0/0 nello strato superiore, che dice "fai finta che qui sotto non ci sia niente".
Ecco perché dieci container dalla stessa immagine occupano lo spazio di una sola immagine, e perché un RUN rm -rf /cache in fondo al Dockerfile non riduce di un byte la dimensione dell'immagine: il file è ancora lì, negli strati inferiori, coperto da un whiteout.
Addio chroot, benvenuto pivot_root
Ricordate l'evasione dal chroot? I runtime moderni non usano chroot() ma pivot_root(2): dentro un nuovo mount namespace, rendono il rootfs del container la nuova radice, spostano la vecchia in una sottodirectory e poi la smontano (umount2(old, MNT_DETACH)). Non c'è più nessuna directory dell'host a cui risalire con ..: la porta dipinta sul muro è stata sostituita da un muro vero.
Per finire, Docker toglie al root del container la maggior parte delle capabilities (niente CAP_SYS_ADMIN, niente CAP_SYS_MODULE...), applica un profilo seccomp che blocca una quarantina abbondante di syscall pericolose e, dove disponibili, aggiunge AppArmor o SELinux. Il root del container è un root con la museruola.
Epilogo: e dopo Docker?
Il successo di Docker fu così rapido da spaventare il resto dell'industria. Nel 2014 Google rilascia Kubernetes, erede spirituale di Borg; CoreOS risponde a Docker con rkt. Per evitare la guerra dei formati, nel 2015 nasce la Open Container Initiative (OCI): Docker dona il suo runtime, diventato runc, e il formato immagine diventa uno standard. Poi Docker estrae il demone di gestione in containerd, donato alla CNCF.
Quando nel 2022 Kubernetes 1.24 rimuove il "dockershim", internet va nel panico: "Kubernetes abbandona Docker!". Non si rompe niente, perché le immagini sono OCI e containerd c'era già sotto. Tutto molto anticlimatico, come le migliori storie di ingegneria.
Riassunto per chi ha scrollato fino a qui
| Ingrediente | Anno | Bugia raccontata al processo |
|---|---|---|
chroot → pivot_root | 1979 / 2000 | "Questa è la tua /" |
| Namespace | 2002–2020 | "Sei PID 1, ti chiami così, questa è la tua rete" |
| Cgroup | 2008 / 2016 (v2) | "La RAM finisce a 100 MB, fidati" |
| Capabilities + seccomp | 1999 / 2005–2012 | "Sei root... più o meno" |
| OverlayFS + immagini | 2013–2014 | "Questo filesystem è tutto tuo (e di altri 40 container)" |
Un container, quindi, non è una piccola macchina virtuale: è un processo a cui il kernel mente in modo molto coerente. Docker non ha inventato queste bugie: ha avuto il merito di raccontarle tutte insieme, con un solo comando e un logo con una balena. Ed è proprio con quattro container (Ghost, MySQL, Postfix e Caddy) che vi sto servendo questa pagina.
Alla prossima storia di bit. 🐳